Metin ve Ağlarda Veri Analizi
MBG4181 Biyolojik Veri Analizi ve Görüntüleme - Ders7
2026-11-09
İki farklı veri tipi
- Metin → {tidytext}: bir özeti (ya da 612 özeti) tabloya çevirmek
- Ağ → {tidygraph}: protein etkileşimlerini grafiğe çevirmek
- Metinden ağa: ikisini birleştirmek
Ortak fikir: veriyi tidy formata çevir, dplyr fiilleriyle veriyi işle, birbirine eklenen parçalar şeklinde analiz.
Neden bu iki konu?
Biyolojik veri iki biçimde gelir:
- Ölçüm: tablo halinde sayılar (önceki derslerde kullandığımız
unvotes,gapminderverileri) - İlişki: “A, B ile etkileşiyor” (protein–protein etkileşim ağı, metabolik ağ, sitogenetik harita)
Bugün iki gerçek veri setiyle çalışacağız:
| Veri | Ne? | Boyut |
|---|---|---|
| PubMed özetleri | EGFR + akciğer kanseri literatürü | 612 özet (2015–2026) |
| İnsan PPI ağı | protein–protein etkileşimleri | 544.494 etkileşim, 19.162 protein |
Eski ders notları
tidytext hakkında eski ders notları: link
tidygraph hakkında eski ders notları: link
Bölüm 1: Metin
{tidytext} ile metni tabloya çeviriyoruz.
Bir metin aslında bir kelime torbası. {tidytext} bunu “bir satır = bir (belge, kelime)” tablosuna çevirir.
Metin verisi de tıpkı tablo verisi gibi tidy: her satır tek bir gözlem.
Bölüm 1: Metin
# A tibble: 8 × 2
   line word
  <dbl> <chr>
1     1 egfr
2     1 mutations
3     1 drive
4     1 non
5     1 small
6     1 cell
7     1 lung
8     1 cancer
Kelimeleri temizlemek
Her metinde aynı “gürültü” kelimeleri var: the, and, of, in…
{tidytext} bir stop words sözlüğü ile gelir; anti_join() ile atarız.
anti_join() = “bu sözlükteki kelimeleri at”.
Örnek veri: makale özetleri
Özetleri PubMed’den indirdik. İndirme kodu data/fetch_pubmed.R dosyasında:
base_query <- 'EGFR[tiab] AND lung[tiab]'
years      <- 2015:2026
per_year   <- 60

pmids <- map(years, function(y) {
  url <- paste0("https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi",
                "?db=pubmed&retmode=json&retmax=", per_year,
                "&term=", URLencode(paste0(base_query, " AND ", y, "[dp]")))
  fromJSON(url)$esearchresult$idlist
})
Sonra efetch ile özet metinleri indirilir, map_dfr() ile tabloya çevrilir.
Korpusumuzu tanıyalım
# A tibble: 612 × 5
       pmid  year journal                                         title abstract
      <dbl> <int> <chr>                                           <chr> <chr>
 1 26051236  2015 The Lancet. Oncology                            Clin… "Most p…
 2 25923549  2015 The New England journal of medicine             AZD9… "The EG…
 3 25589191  2015 The Lancet. Oncology                            Afat… "We aim…
 4 25936890  2015 Zhongguo fei ai za zhi = Chinese journal of lu… [TKI… "Epider…
 5 25745851  2015 Respiratory investigation                       Dise… "A rece…
 6 25983263  2015 Archives of toxicology                          Role… "Lung c…
 7 26514492  2015 Asian Pacific journal of cancer prevention : A… Corr… "Epider…
 8 26022942  2015 Molecular aspects of medicine                   Targ… "The de…
 9 25908911  2015 Current oncology (Toronto, Ont.)                Mana… "Target…
10 25870795  2015 Translational lung cancer research              Mole… "Somati…
# ℹ 602 more rows
Beş sütun: pmid, year, journal, title, abstract.
Korpusumuzu tanıyalım
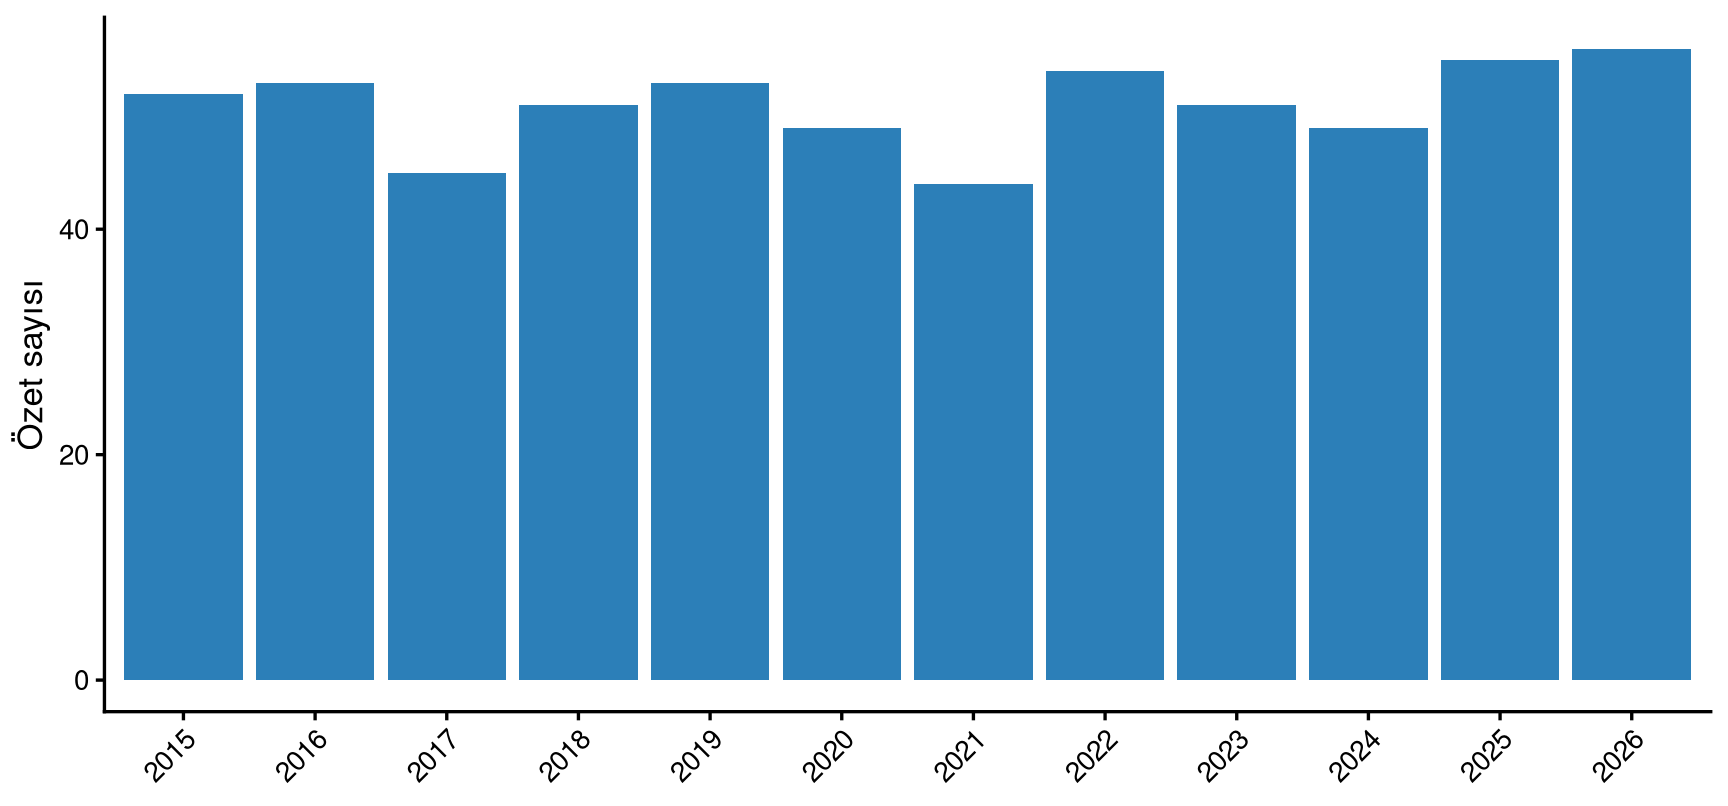
Her yıl en fazla 60 özet: yıllar arası karşılaştırma dengeli bir veriyle yapılsın diye.
Korpusumuzu tanıyalım
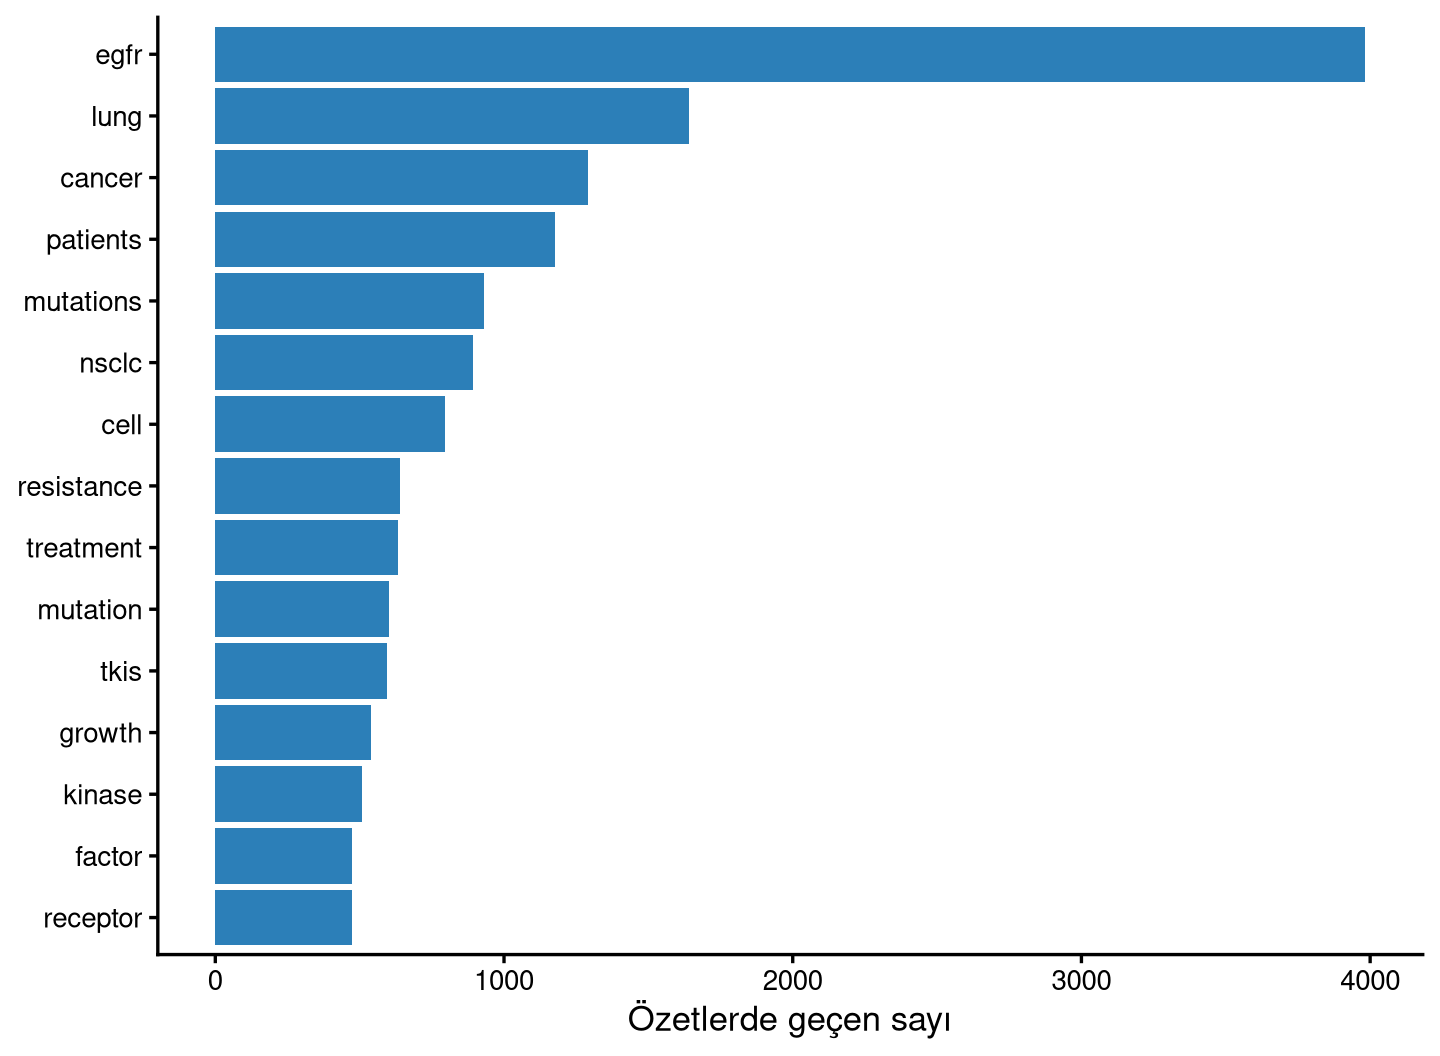
En sık kelimeler
# A tibble: 10 × 2
   word           n
   <chr>      <int>
 1 egfr        3983
 2 lung        1640
 3 cancer      1292
 4 patients    1176
 5 mutations    931
 6 nsclc        892
 7 cell         794
 8 resistance   640
 9 treatment    633
10 mutation     603
En sık kelimeler
egfr, lung, cancer … korpusun konusu burada çıkıyor.
En sık kelimeler
Kavramların yıllara göre sayımı
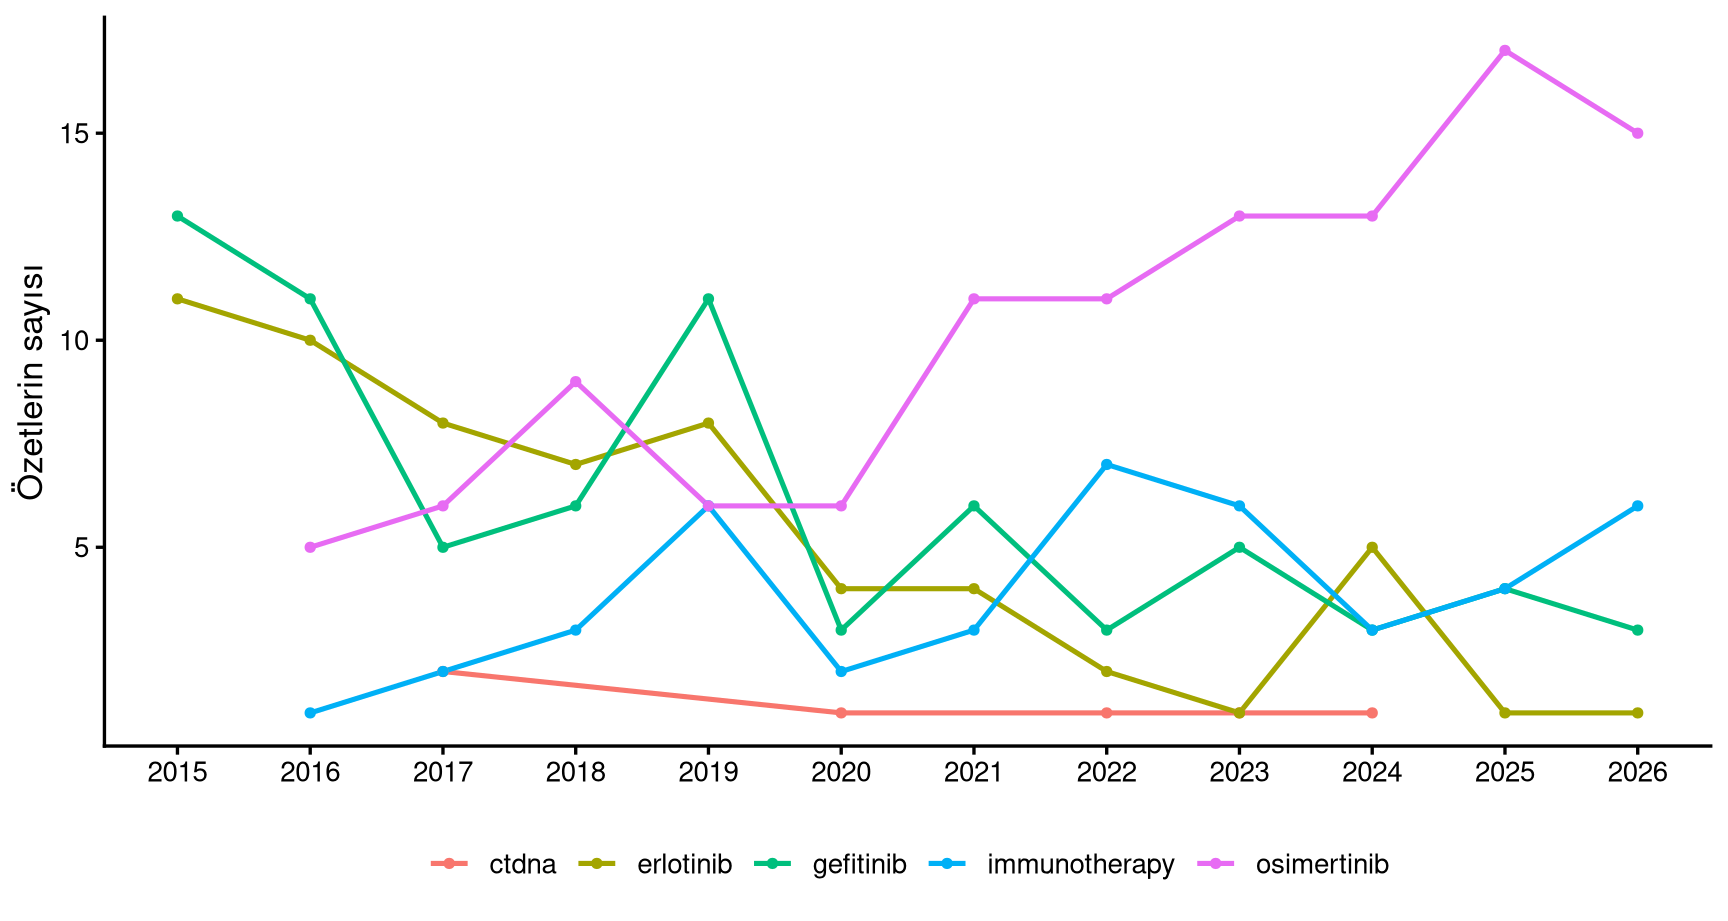
Hangi terim yıllara göre ne kadar sık kullanıldı? sorusu tidy formattaki veri ile kolayca hesaplanabilir.
Aradığımız kelimeleri bir tabloya yazıp metni kelimelere bölelim; ikisini join ile eşleştirelim.
# A tibble: 51 × 3
    year term              n
   <int> <chr>         <int>
 1  2015 erlotinib        11
 2  2015 gefitinib        13
 3  2016 erlotinib        10
 4  2016 gefitinib        11
 5  2016 immunotherapy     1
 6  2016 osimertinib       5
 7  2017 ctdna             2
 8  2017 erlotinib         8
 9  2017 gefitinib         5
10  2017 immunotherapy     2
# ℹ 41 more rows
Trend grafiği
Osimertinib yükseliyor.
Trend grafiği
İki kelime birlikte: bigram
Tek kelime yetmez: “lung cancer”, “EGFR mutation”, “tyrosine kinase” gibi ifadeler birlikte anlamlıdır.
bigrams <- corpus |>
  unnest_tokens(bigram, abstract, token = "ngrams", n = 2) |>
  separate_wider_delim(bigram, delim = " ", names = c("word1", "word2")) |>
  anti_join(stop_words, by = c("word1" = "word")) |>
  anti_join(stop_words, by = c("word2" = "word")) |>
  filter(!is.na(word1), !is.na(word2)) |>
  count(word1, word2, sort = TRUE)

bigrams |> slice_head(n = 10)
anti_join() ile stop_words temizliği yapamayız, ikili kelimelerin iki ayrı kolona ayrılması (separate_) daha sonra her iki kolondaki stop_words ayrı ayrı temizlenmesi gerekmektedir..
İki kelime birlikte: bigram
# A tibble: 10 × 3
   word1     word2         n
   <chr>     <chr>     <int>
 1 lung      cancer      965
 2 cell      lung        424
 3 growth    factor      410
 4 egfr      tkis        396
 5 factor    receptor    394
 6 epidermal growth      385
 7 tyrosine  kinase      368
 8 egfr      mutations   346
 9 receptor  egfr        323
10 egfr      mutant      299
TF-IDF: ayırt edici kelimeler
- tf: kelime bir belgede ne kadar sık
- idf: kelime tüm belgelerde ne kadar nadir
\[idf(\text{terim}) = \ln{\left(\frac{n_{\text{belge}}}{n_{\text{terimi içeren belge}}}\right)}\]
# A tibble: 6,122 × 6
       pmid word         n    tf   idf tf_idf
      <dbl> <chr>    <int> <dbl> <dbl>  <dbl>
 1 39720671 as1          4     1  4.71   4.71
 2 28783064 estrogen     6     1  4.64   4.64
 3 27149849 pkm2         6     1  4.63   4.63
 4 29133145 ddx59        5     1  4.63   4.63
 5 25656847 smarce1      5     1  4.62   4.62
 6 27760600 sqclc        4     1  4.62   4.62
 7 31420907 atf1         4     1  4.62   4.62
 8 36975376 tmprss2      5     1  4.59   4.59
 9 36268218 hts          5     1  4.57   4.57
10 36410436 2d5          4     1  4.57   4.57
# ℹ 6,112 more rows
Gerçek hayatta gürültü olur
tf-idf nadir kelimeleri öne çıkarır; küçük veri kümelerinde bu “nadir” kelimeler bazen yazar adı ya da kısaltma olur. Bu yüzden filtreleme (n >= 3) gerekebilir.
Bölüm 2: Ağ
{tidygraph} ile ilişkileri grafiğe çeviriyoruz.
Ağ nedir?
- Düğüm (node): bir nesne (protein, gen, kelime)
- Kenar (edge): iki düğüm arasındaki ilişki

Düğüm ve kenar
Soldaki iki düğüm arasına, sağdaki gibi bir kenar (bağ) çizilir.


Tidy graph: iki tablo
{tidygraph} bir grafiği iki tablo ile tutar: düğümler ve kenarlar. İkisi de {dplyr} fiilleriyle işlenir.

Mini örnek: arkadaşlık ağı
Küçük bir ağla başlayalım (arkadaşlık = yönsüz).
# A tibble: 9 × 2
  person1 person2
  <chr>   <chr>
1 alice   bob
2 charles bob
3 david   bob
4 bob     allen
5 fiona   bob
6 gary    bob
7 bob     henry
8 alice   allen
9 david   fiona
Arkadaşlık ağı grafiği
# A tbl_graph: 8 nodes and 9 edges
#
# An undirected simple graph with 1 component
#
# Node Data: 8 × 1 (active)
  name
  <chr>
1 alice
2 charles
3 david
4 bob
5 fiona
6 gary
7 allen
8 henry
#
# Edge Data: 9 × 2
   from    to
  <int> <int>
1     1     4
2     2     4
3     3     4
# ℹ 6 more rows
Ağı görselleştirmek
{ggraph} = {ggplot} mantığı, ama x/y yerine düğüm ve kenar bilgisi.
Ağı görselleştirmek
Derece (degree)
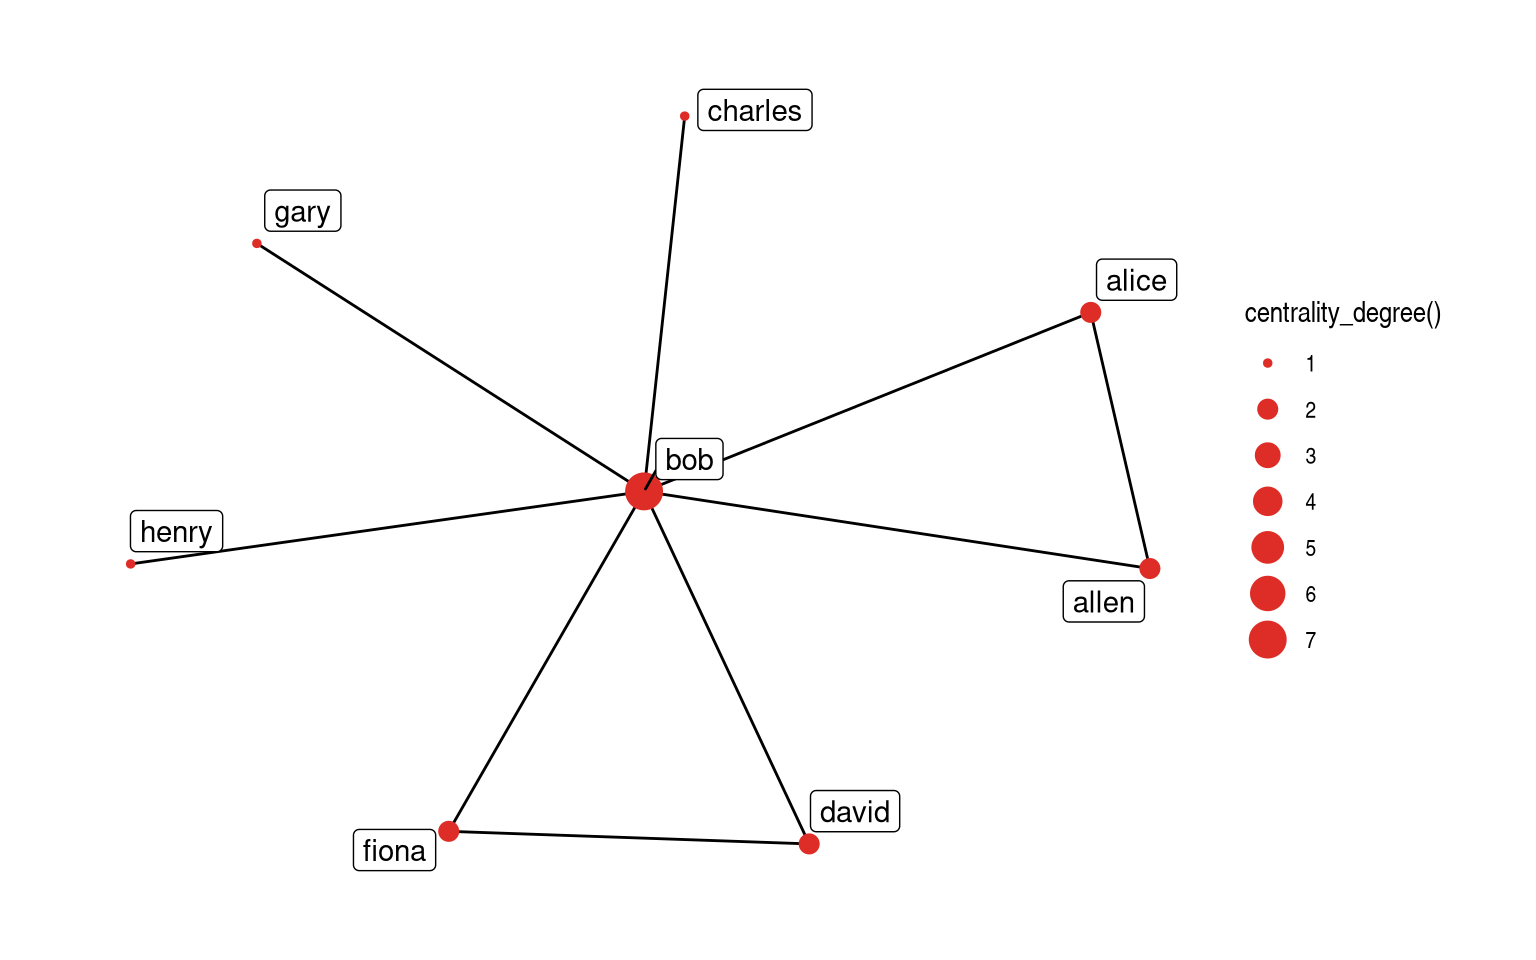
Bir düğümün kaç kenarı var? (Yönsüz ağda “kaç kişiyle bağlantılı”)
# A tibble: 8 × 2
  name      deg
  <chr>   <dbl>
1 bob         7
2 alice       2
3 david       2
4 fiona       2
5 allen       2
6 charles     1
7 gary        1
8 henry       1
Yönlü ağda ayrım önemlidir:
Yönlü ağda derece
Arkadaşlık ağını “yönlü” olarak oluşturup içe doğru, dışa doğru ve toplam derece sayımı yapalım
# A tbl_graph: 8 nodes and 9 edges
#
# A directed acyclic simple graph with 1 component
#
# Node Data: 8 × 4 (active)
  name    in_deg out_deg all_deg
  <chr>    <dbl>   <dbl>   <dbl>
1 alice        0       2       2
2 charles      0       1       1
3 david        0       2       2
4 bob          5       2       7
5 fiona        1       1       2
6 gary         0       1       1
7 allen        2       0       2
8 henry        1       0       1
#
# Edge Data: 9 × 2
   from    to
  <int> <int>
1     1     4
2     2     4
3     3     4
# ℹ 6 more rows
Örnek veri: PPI ağı
Protein-protein etkileşim ağları biyolojide önemli bir veri tipidir.
# A tibble: 5 × 2
  interactor_A interactor_B
  <chr>        <chr>
1 MAP2K4       FLNC
2 MYPN         ACTN2
3 ACVR1        FNTA
4 GATA2        PML
5 RPA2         STAT3
İki sütun: interactor_A, interactor_B. Kısaltılmış protein adları (UniProt/S_HUMAN). Tablo 19.162 protein / 544.494 etkileşim: çok büyük, bu yüzden sonraki adımlarda alt küme alacağız.
Protein-protein etkileşim verileri
Aşağıdaki veritabanlarından protein-protein etkileşim verileri elde edilebilir (Halka açık veritabanlarında genelde Download kısmında, veritabanındaki tüm veri csv formatında paylaşılır)
- STRING (string-db.org): 12.000’den fazla organizmadaki bilinen ve tahmin edilen protein etkileşimlerini (fiziksel bağlanma ve işlevsel yolaklar) kapsar.
- BioGRID (thebiogrid.org): Başlıca model organizmalar ve insan literatüründen derlenen kapsamlı protein, genetik ve kimyasal etkileşimleri içeren biyomedikal bir depodur.
- IntAct (ebi.ac.uk/intact): EMBL-EBI tarafından yönetilen, literatürdeki deneysel verilerin manuel olarak düzenlendiği ücretsiz ve açık kaynaklı bir moleküler etkileşim veritabanıdır.
Tablodan ağa (grafiğe)
as_tbl_graph komutu, bir tabloyu ağ yapısına çevirir, iki tablo halinde, düğüm + kenar, saklar.
# A tbl_graph: 19162 nodes and 544494 edges
#
# An undirected multigraph with 3 components
#
# Node Data: 19,162 × 1 (active)
   name
   <chr>
 1 MAP2K4
 2 MYPN
 3 ACVR1
 4 GATA2
 5 RPA2
 6 ARF1
 7 ARF3
 8 XRN1
 9 APP
10 APLP1
# ℹ 19,152 more rows
#
# Edge Data: 544,494 × 2
   from    to
  <int> <int>
1     1  3667
2     2  2393
3     3  3803
# ℹ 544,491 more rows
Düğüm ve kenar tabloları
Aksi belirtilmedikçe, aktif olan tablo düğüm tablosudur, kenar tablosu üzerinde, select, filter, mutate, join uygulanacak ise, activate(edges) kullanılmalıdır
# A tbl_graph: 19162 nodes and 544494 edges
#
# An undirected multigraph with 3 components
#
# Edge Data: 544,494 × 2 (active)
    from    to
   <int> <int>
 1     1  3667
 2     2  2393
 3     3  3803
 4     4  1415
 5     5  2286
 6     6   569
 7     7   329
 8     7  4241
 9     8  8204
10     9   840
# ℹ 544,484 more rows
#
# Node Data: 19,162 × 1
  name
  <chr>
1 MAP2K4
2 MYPN
3 ACVR1
# ℹ 19,159 more rows
Ağın hub genleri
Derecesi en yüksek proteinler ağın hub’larıdır.
Hub genleri grafiği
ppi_g |>
      activate(nodes) |>
      mutate(deg = centrality_degree()) |>
      filter(deg >= 1500) |>
      ggraph(layout = "kk") +
      geom_edge_link(colour = "grey75") +
      geom_node_point(aes(size = deg), colour = "#de2d26") +
      scale_size_area(max_size = 11) +
      geom_node_label(aes(label = name), repel = TRUE, size = 3.4,
                      segment.colour = "grey60", fill = "white") +
      theme_graph()
Hub genleri grafiği
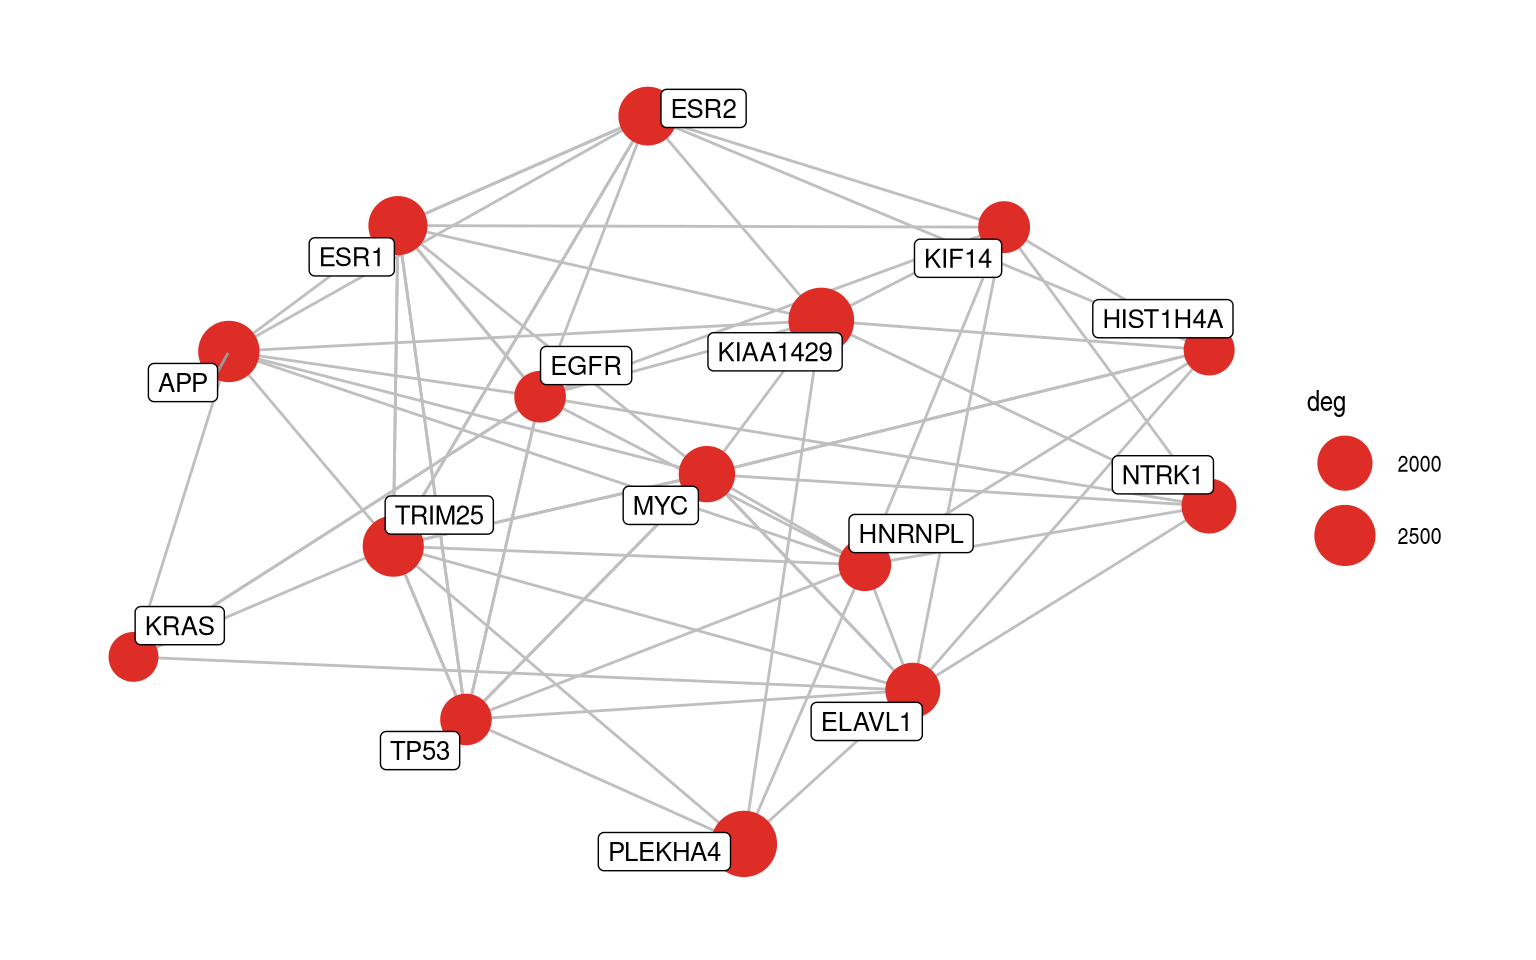
Merkezilik: betweenness
Derece “çok kapısı var” demektir. Betweenness ise “ağın ortasında mı?”: en kısa yolların kaçından geçiyor.
# A tbl_graph: 184 nodes and 7450 edges
#
# An undirected multigraph with 1 component
#
# Node Data: 184 × 3 (active)
   name     deg  betw
   <chr>  <dbl> <dbl>
 1 RPA2     563  20.9
 2 APP     2515  87.9
 3 EP300    919  66.4
 4 BRCA1   1247  68.4
 5 RPA1     603  38.9
 6 YWHAZ    557 124.
 7 CSK      815  18.3
 8 CREBBP   567  16.2
 9 ESR1    2320 119.
10 NR3C1    886  12.3
# ℹ 174 more rows
#
# Edge Data: 7,450 × 2
   from    to
  <int> <int>
1     1    56
2     5    56
3    21   153
# ℹ 7,447 more rows
Düzen (layout)
Ağın şekli veriden gelmez, çizim seçiminden gelir. En iyisi birkaçını denemektir.

Bölüm 3: Metinden ağa
Aynı fikir, metin verisiyle.
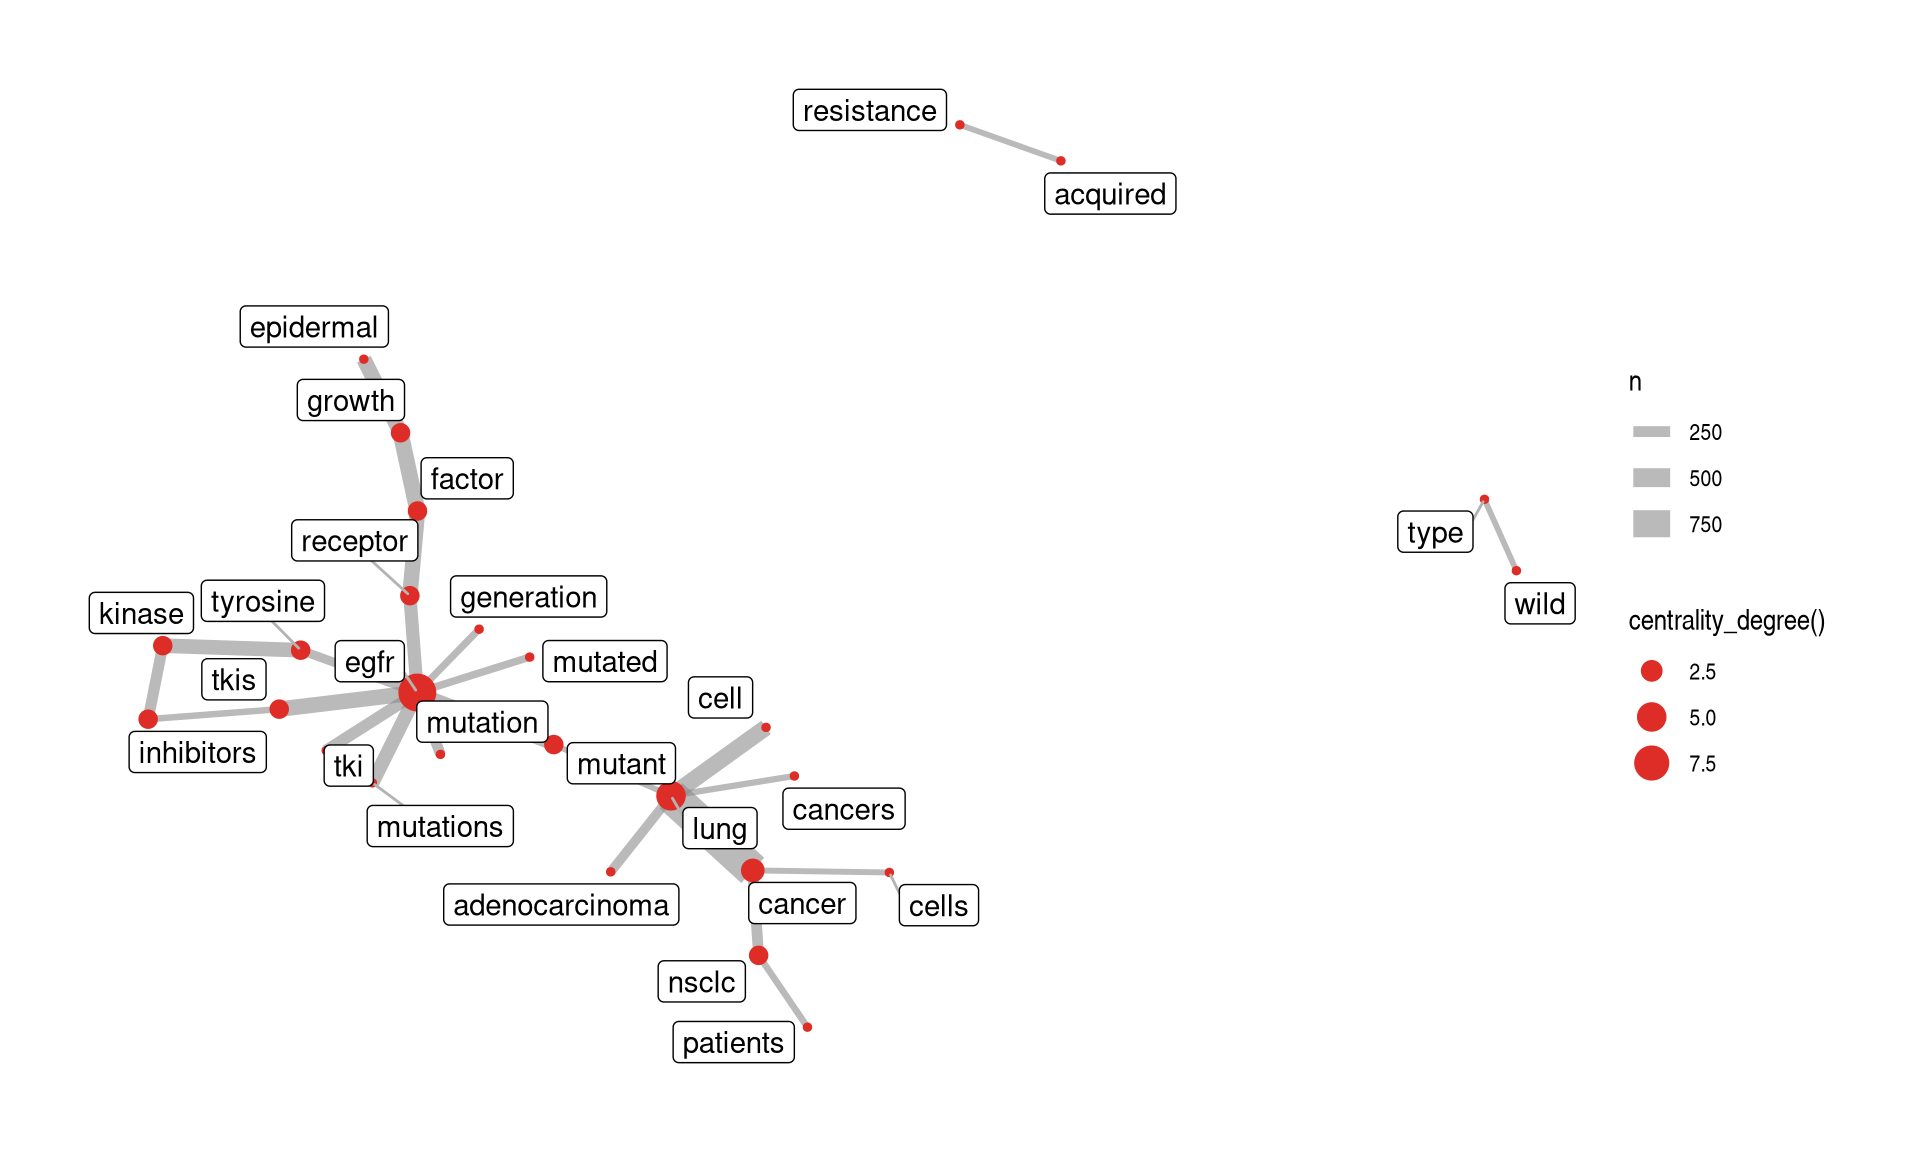
Bigram ağı
Bigram sayımında elimizde word1, word2 ve bir sayı var. Bu tam olarak “iki düğüm + aralarındaki kenar” demek.
egfr düğümü merkezde: EGFR – TKI’lar, EGFR – mutasyonlar etrafında toplanıyor.
Bigram ağı
İki ağ, aynı gramer
| Metin ağı | Protein ağı | |
|---|---|---|
| Düğüm | kelime | protein |
| Kenar | “bu kelime şu kelimeden sonra geçti” | “bu iki protein etkileşiyor” |
| Ağırlık | kaç kez geçti | kaç etkileşim |
| Merkezilik | en çok “köprü” kuran kelime | sinyal yolunun kilit geni |
Aynı araçlar, farklı alan.
Tidy fiiller lego gibi birleştirilebilir
Farklı paketlerin fonksiyonları tidy veri alıp tidy veri verir; bu yüzden uç uca eklenebilirler.
corpus |>                                    # veri
  unnest_tokens(word, abstract) |>          # tidytext
  anti_join(stop_words, by = "word") |>     # dplyr
  count(year, word) |>                      # dplyr
  filter(n > 5) |>                          # dplyr
  pivot_wider(names_from = word, values_from = n) |>   # tidyr
  as_tbl_graph(directed = FALSE) |>         # tidygraph
  activate(edges) |>
  mutate(betw = centrality_edge_betweenness()) |>      # tidygraph
  ggraph(layout = "kk") +                   # ggraph
  geom_node_point() +                       # ggraph
  geom_edge_link()                          # ggraph
Sorular
corpusiçinde 2015 yılı özetlerini alın; en sık 10 kelimeyi bulun.trendtablosundan 2020 yılında en yüksek terimi bulun; o terimin yıllar boyunca yüzdelerini çizdirin.ppi_giçinde “EGFR” düğümünü bulun; derecesini ve kaç komşusu olduğunu yazdırın.bigramsiçinden “egfr” kelimesini içeren 10 ikili kelime çıkarın.
Özet
- Metin de, ağ da tabloyla başlar: tidy veri + dplyr fiilleri.
- {tidytext} metni kelime/bigram tablosuna çevirir; {tidygraph} ilişkiyi grafiğe çevirir.
- İkisi aynı fikrin iki yüzü: tablo → ölçüm, ağ → ilişki.
- Aynı araç zinciri farklı veriyle çalışır: PubMed özeti de, PPI ağı de.